 커밋 한 모금
gemma 4 31b 성능 실측: 맥 스튜디오 로컬 llm 분석
맥 스튜디오 M5 Max, 통합 메모리 48GB 환경에서 빠른 응답 속도와 자연스러운 한국어 문장 생성이 필요한 사용자에게 맞습니다.
맥 스튜디오 로컬 llm 환경에서 mlx-community/gemma-4-31b-it-4bit 모델의 gemma 4 31b 성능을 직접 측정했습니다. 짧은 입력 답 쓰는 속도는 초당 28.2토큰으로 사람이 읽는 속도(초당 약 다섯 토큰 안팎)보다 빠릅니다. 한국어 답변 점수는 5점 만점에 5점을 기록했으며 최대 메모리 사용량은 20.9GB였습니다.
이 맥에서 잰 숫자
| 모델 | gemma-4-31b-it-4bit |
|---|---|
| 원본 저장소 | mlx-community/gemma-4-31b-it-4bit |
| 가중치 용량(GB) | 18.4 |
| 라이선스 | gemma |
| 측정 기기 | 맥 스튜디오 M5 Max, 통합 메모리 48GB |
| 측정 도구 | mlx-lm 0.32.0 (MLX 0.32.3) |
| 측정일 | 2026-10-21 |
| 짧은 입력(512토큰) 답 쓰는 속도(토큰/초) | 28.2 |
| 짧은 입력 읽는 속도(토큰/초) | 743 |
| 긴 입력(4096토큰) 답 쓰는 속도(토큰/초) | 26.8 |
| 긴 입력 읽는 속도(토큰/초) | 800 |
| 최대 메모리 사용(GB) | 20.9 |
| 한국어 답변 점수(5점 만점) | 5 |
| 한국어 답변에 외국어 섞임 | 없음 |
| 한국어 객관식(KMMLU 50문항) 정답 | 33 / 50 |
| 도구 호출 정확도(10문항) | 10 / 10 |
| 파이썬 코딩(10문제, 테스트 전부 통과) | 10 / 10 |
| 형식 지시 따르기(10문항) | 10 / 10 |
| 긴 글 속 문장 찾기(약 16K토큰) | 찾음 (27.5초) |
| 한 번에 만든 튀는 공 애니메이션 | 움직임 |
답 쓰는 속도는 1초에 만들어 내는 토큰(글자 조각) 수입니다. 같은 모델도 기기·메모리·도구 버전에 따라 달라집니다.
한국어로 물어봤더니
질문: 맥에서 로컬 AI 모델을 처음 써 보려는 대학생에게, 장점 두 가지와 주의할 점 한 가지를 한국어로 짧게 알려 줘.
맥에서 로컬 AI 모델 입문을 환영합니다! 핵심만 짧게 알려드릴게요. **✅ 장점** 1. **개인정보 보호:** 데이터가 외부 서버로 전송되지 않아 민감한 과제나 개인적인 내용을 안심하고 입력할 수 있습니다. 2. **비용 및 제약 없음:** 한 번 설치하면 인터넷 연결 없이도 무료로 사용할 수 있으며, 기업의 필터링 제한 없이 자유로운 답변을 얻을 수 있습니다. **⚠️ 주의할 점** * **리소스 소모:** 모델 구동 시 RAM(메모리)과 GPU를 많이 사용하므로, 실행 중에는 다른 무거운 프로그램이 느려지거나 배터리가 빠르게 소모될 수 있습니다.
요청된 형식과 내용을 정확히 전달하며 문장이 매우 자연스럽습니다.
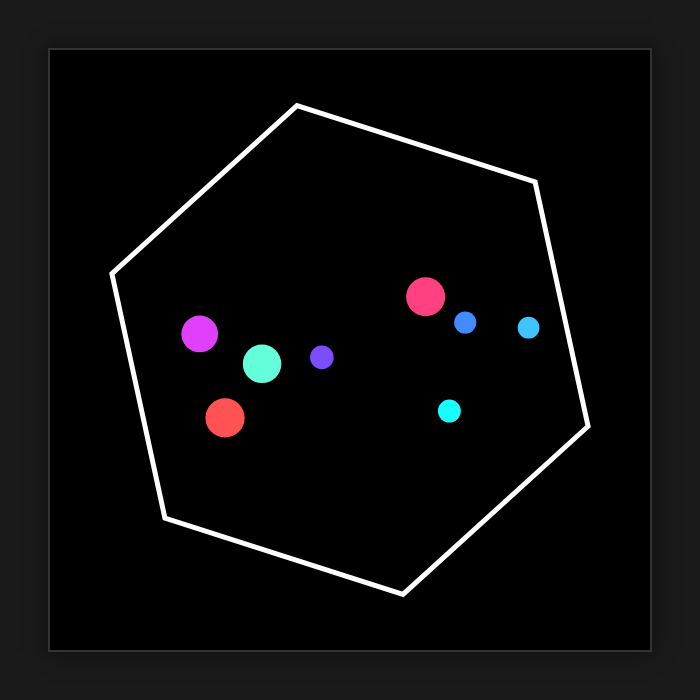
한 번에 만든 튀는 공 애니메이션
"회전하는 육각형 안에서 공 8개가 튀는 HTML 을 한 파일로 만들어 줘"라는 요청에 처음 낸 답을 그대로 실행한 화면입니다.
이럴 때 맞아요
- 맥 스튜디오 M5 Max, 통합 메모리 48GB 환경에서 로컬 LLM을 안정적으로 구동할 때
- 도구 호출(10 / 10) 및 파이썬 코딩(10 / 10), 형식 지시 따르기(10 / 10)의 정확한 수행이 필요할 때
- 사람이 읽는 속도보다 빠른 응답 속도(짧은 입력 초당 28.2토큰)가 필요할 때
이럴 때는 다른 모델을
- 가중치 용량 18.4GB 및 최대 메모리 사용 20.9GB를 확보하기 어려운 기기 환경
- 한국어 객관식 시험(KMMLU 50문항 중 33 정답)에서 더 높은 정답률이 요구되는 작업
자주 묻는 질문
gemma 4 31b it 답 쓰는 속도는 얼마나 빠른가요?
짧은 입력(512토큰) 기준 초당 28.2토큰, 긴 입력(4096토큰) 기준 초당 26.8토큰입니다. 이는 사람이 읽는 속도(초당 약 다섯 토큰 안팎)보다 빠릅니다.
맥에서 실행할 때 메모리는 얼마나 사용하나요?
가중치 용량은 18.4GB이며, 최대 메모리 사용량은 20.9GB입니다. 측정 기기는 맥 스튜디오 M5 Max, 통합 메모리 48GB였습니다.
한국어 답변 품질과 코딩 성능은 어떤가요?
한국어 답변 점수는 5점 만점에 5점(외국어 섞임 없음)이었으며, 파이썬 코딩 10문제와 도구 호출 10문항, 형식 지시 따르기 10문항 모두 10 / 10을 기록했습니다.
긴 글 검색 성능은 어떤가요?
약 16K토큰 분량의 긴 글 속 문장 찾기에서 27.5초 만에 문장을 찾았습니다.
측정 방법
맥 스튜디오 M5 Max, 통합 메모리 48GB에서 mlx-lm 0.32.0 (MLX 0.32.3)로 측정했습니다. 입력 512토큰·4096토큰 뒤 128토큰을 생성하는 시험을 여러 번 반복한 평균이고, 한국어 답변은 온도 0으로 한 번 생성한 원문 그대로입니다(생각 과정은 떼고 답만). 추가 시험(있는 경우)은 모두 코드로 채점합니다: 한국어 객관식은 KMMLU(HAERAE-HUB, CC BY-ND 4.0) 10개 분야 50문항, 도구 호출·파이썬 코딩·형식 지시는 각 10문항(코딩은 인터넷이 막힌 환경에서 숨겨진 테스트 실행), 긴 글 찾기는 약 1만6천·3만2천 토큰 글 속에 넣은 문장을 찾는지, 튀는 공은 한 번에 만든 HTML 이 실제로 움직이는지입니다. 생각 기능은 끄고 온도 0으로 실행했습니다. 가중치는 Hugging Face의 mlx-community/gemma-4-31b-it-4bit를 썼습니다.
측정일 2026-10-21 · 커밋 한 모금